
搜索到
1
篇与
的结果
-
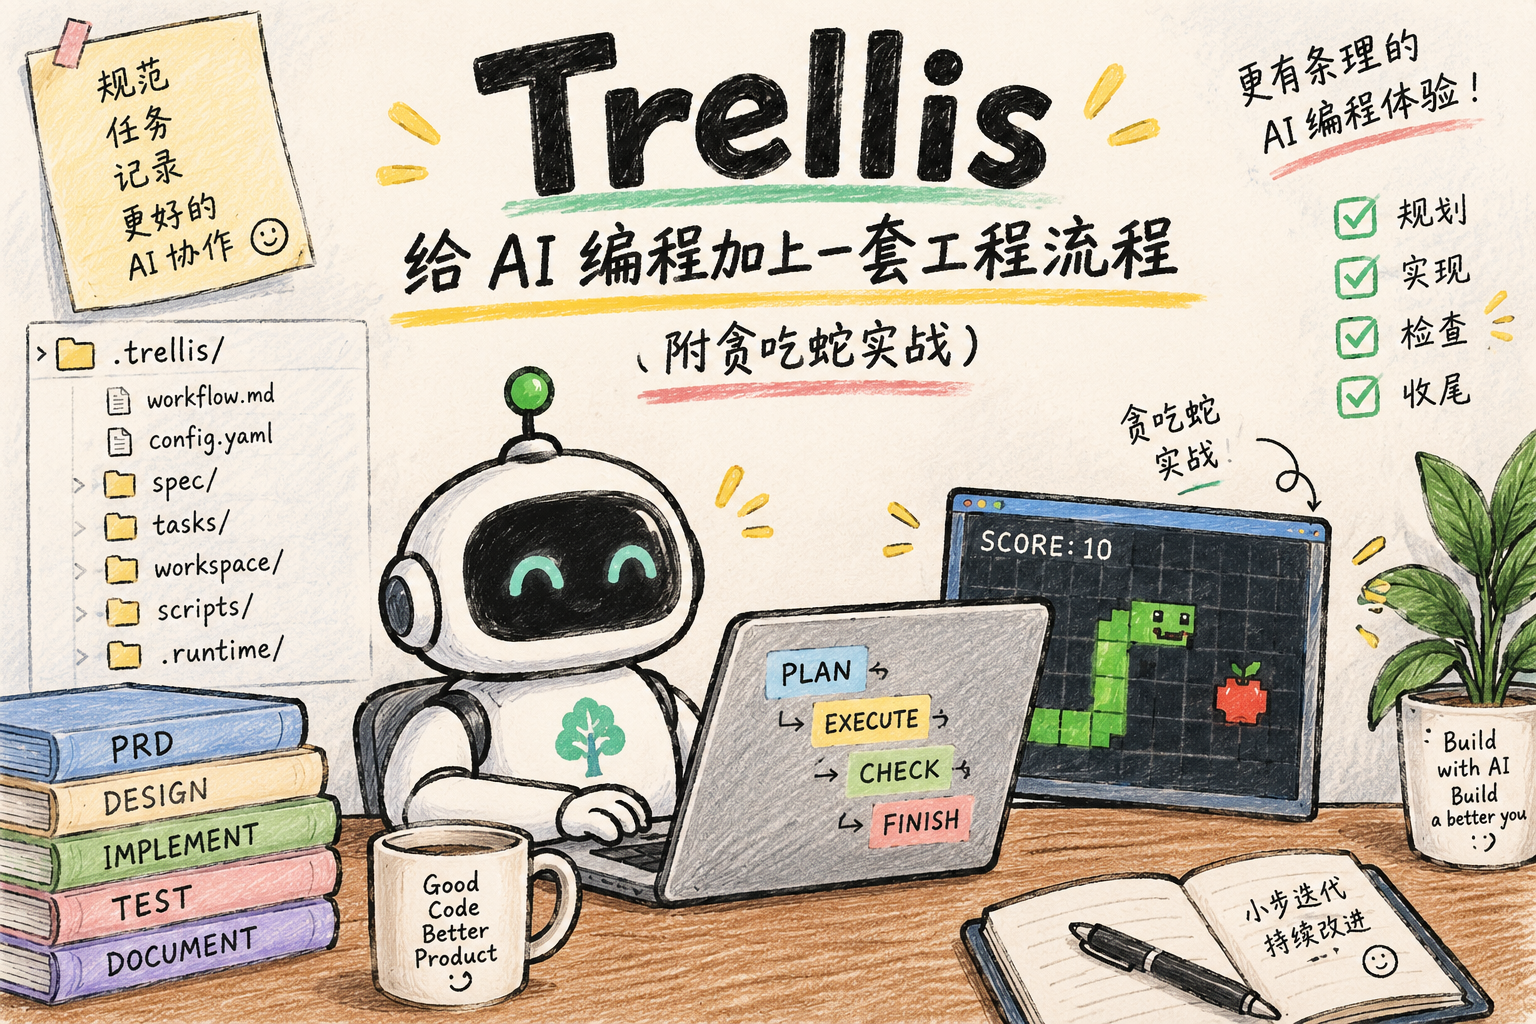
 Trellis:给 AI 编程加上一套工程流程(附贪吃蛇实战) AI 写代码的速度确实很快,真正让人头疼的却不是“它会不会写”,而是“它下次还记不记得项目规范、上次做到哪、这次改动有没有经过检查”。Trellis 想解决的,就是这件事。前言这两年用了不少 AI Coding 工具,感受很明显:让 AI 生成一个页面、补一个接口,通常不难;难的是连续做几周以后,项目里的上下文开始散掉。比如这次让它改一个接口,得重新解释异常怎么处理;下次开新会话,又要再贴一遍目录结构、测试要求和提交规范。任务大一点时,需求、方案、代码、检查结果还会散落在聊天记录里。聊天一长,前面的结论基本等于没发生过。Trellis 不是另一个模型,也不是 IDE。它更像是一层放进项目里的工作流:把规范、任务和会话记录都落到文件里,再按当前阶段交给 AI。它不保证 AI 从此不犯错,但能把不少“本来应该提前想到”的事情变成固定步骤。一、Trellis 是什么Trellis 是面向 AI 编程的工程化工作流工具。初始化后,它会在项目中生成一套 .trellis/ 目录和对应平台的配置文件;之后无论用 Codex、Claude Code、Cursor 还是其他支持的平台,AI 都能按同一套任务、规范和检查流程协作。它主要解决 4 件事:规范不用反复贴:把项目约定放进 Spec,AI 在实现和检查时按需读取;需求不只存在聊天里:一个任务有自己的 PRD、设计、实施计划和研究记录;会话切换不容易失忆:重要过程写入工作日志,后续会话可以接着做;实现后有检查环节:代码不是“生成完就结束”,还要回到任务要求、规范和测试上过一遍。官方把它称为 AI coding 的工程框架。这个描述不算夸张:它关心的不是帮你多写几行代码,而是让 AI 的每一次改动更接近正常开发流程。官方仓库 和 npm 包 都可以直接查看最新版本与文档。二、.trellis 目录里有什么初始化后,项目里最核心的是下面几部分:.trellis/ ├── workflow.md # 工作流:规划、实现、检查、收尾 ├── config.yaml # 项目级配置 ├── spec/ # 项目规范 ├── tasks/ # 任务与任务产物 ├── workspace/ # 开发者会话日志 ├── scripts/ # 本地任务与上下文运行脚本 └── .runtime/ # 会话级运行状态(自动生成)1. workflow.md:告诉 AI 现在该做什么这里定义的是任务节奏,通常分为:Plan → Execute → Finish规划阶段先把需求说清楚;实现阶段再写代码和检查;收尾阶段补充规范、提交并归档任务。听起来有点“流程化”,但在 AI 编程里很有必要。因为一句“帮我做个用户管理”包含的东西太多了:要不要分页?权限怎么分?失败怎么提示?有没有现成接口?不先收敛需求,AI 很容易按自己的理解补全,最后看起来什么都有,实际并不贴合项目。2. spec/:项目规范的长期存放处Spec 不是一份泛泛的编码建议,而是项目真实约定。例如:spec/ ├── frontend/ │ ├── directory-structure.md │ ├── state-management.md │ └── quality-guidelines.md ├── backend/ │ ├── database-guidelines.md │ ├── error-handling.md │ └── logging-guidelines.md └── guides/这里可以记录组件放哪里、接口异常怎么返回、数据库迁移怎么写、哪些逻辑必须有测试。以后创建任务时,只把和当前任务相关的 Spec 注入给 AI,不需要让它每次读一大坨规则。我比较认同这一点:规则应该跟着代码仓库走,而不是只躺在某个同事的提示词收藏夹里。3. tasks/:一件事从需求到完成的完整记录一个任务目录通常长这样:tasks/09-18-snake-game/ ├── task.json # 状态、负责人、优先级等元数据 ├── prd.md # 需求与验收标准 ├── design.md # 技术设计(复杂任务才需要) ├── implement.md # 实施步骤与验证方式 ├── implement.jsonl # 实现代理要读的规范/研究清单 ├── check.jsonl # 检查代理要读的规范/研究清单 └── research/ # 调研记录其中最实用的是 prd.md。它不是产品文档的摆设,而是后面验收代码的依据:哪些功能必须做、哪些明确不做、做到什么程度才算完成,都应该写在这里。4. workspace/:给跨会话留一份可追溯的记录聊天记录会压缩、会丢上下文,工作日志不会。workspace/ 按开发者记录会话摘要、关键决定和提交信息。下次继续一个任务时,先看任务文件,再看日志补背景,基本不会出现“昨天做到哪了”的问题。三、安装 TrellisTrellis 的前置要求是 Node.js 20+ 和 Python 3.9+。准备好后,先全局安装:npm install -g @mindfoldhq/trellis@latest进入需要接入的项目目录,执行初始化:cd your-project trellis init -u your-nameyour-name 会成为开发者身份,并创建对应的个人工作区。如果只使用特定 AI 工具,可以显式指定。例如我现在用 Codex:trellis init -u luca --codex也可以同时配置多个平台:trellis init -u luca --claude --cursor --codex初始化后,先别急着让 AI 开始写业务代码。建议先把 .trellis/spec/ 里的模板补成项目真实规范:目录怎么划分、异常怎么处理、前端状态放哪里、测试最低要求是什么。Spec 越贴近现状,后面得到的代码就越像项目原本的代码。提示:Trellis 的 CLI 和项目内模板是两套版本。升级 CLI 后,通常还需要在项目目录执行 trellis update 同步生成文件;如果提示迁移要求,再按提示执行 trellis update --migrate。具体以官方安装文档为准。四、日常怎么用日常使用不需要把每个命令背下来。最常见的流程就是下面这 4 步。1. 先说清楚要做什么直接对 AI 描述需求,例如:给管理后台增加一个导出功能,支持按当前筛选条件导出 Excel。Trellis 会引导 AI 进入规划:先确定筛选条件从哪里来、导出列有哪些、数据量大时怎么处理、哪些边界属于本次范围。结论会写入 prd.md,而不是只停留在对话里。2. 规划完成后再开始实现复杂任务会补充 design.md 和 implement.md。设计文档负责回答“怎么做、为什么这样做”,实施计划负责列出改哪些文件、怎么验证、哪里可以回退。任务准备好后,Trellis 会把相关 Spec、PRD 和研究资料交给实现代理。实现代理只负责在范围内写代码,不顺手扩大需求,也不替主会话做提交。3. 让检查代理复核实现结束后,检查代理会重新对照 PRD 和 Spec,跑 lint、类型检查和测试。能机械修复的地方直接修,例如缺失导入、类型问题、明显的边界遗漏;涉及产品取舍的地方则会留下问题,不会擅自改需求。这个环节很适合发现“功能看似正常,但遗漏了验收条件”的问题。4. 收尾时归档和沉淀任务结束前,检查这次有没有产生值得写进 Spec 的经验。例如某个接口的错误码约定、一个容易踩的并发问题、某类组件的固定写法。确认无误后,再完成提交、归档任务和记录会话。下一次面对类似需求,AI 就能从现有 Spec 和任务历史里拿到更准确的上下文。五、小实战:用 Trellis 做一个贪吃蛇下面用一个简单但完整的例子,看看 Trellis 到底帮了什么。需求很直接:做一个能在浏览器中直接打开的网页版贪吃蛇,只支持桌面键盘操作。1. 先把范围钉住一开始如果只说“做个贪吃蛇”,AI 很可能顺手加移动端按键、难度选择、排行榜甚至音效。它们不一定错,但不一定是这次想要的。这次在 PRD 里明确写了:需要:方向键控制、计分、随机食物、撞墙/撞自己结束、重新开始。 不需要:后端、排行榜、存档、联网、移动端触摸按钮。同时给出可观察的验收标准:食物不能生成在蛇身上;吃到食物后长度和分数要增加;撞墙或撞到自己要停止;重新开始不能残留旧定时器。这一步花不了多久,却能避免后面返工。2. 设计保持简单因为没有现成前端工程,也不需要后端,最终只新增 3 个文件:index.html # 页面结构、Canvas 棋盘、状态和重开按钮 styles.css # 桌面端样式 game.js # 游戏状态、输入、循环、碰撞和绘制游戏状态集中在 game.js:蛇身数组、当前方向、下一步方向、食物坐标、分数、运行状态和计时器。一次 tick 的过程也很直白:键盘输入 → 更新下一步方向 → 计算新蛇头 → 判断撞墙/撞身 → 吃食物或移动蛇身 → 重绘画面这里有两个小细节值得提前写在设计里:方向键会触发浏览器滚动,需要阻止默认行为;重开前必须清理旧的 setInterval,否则会出现两套循环同时跑,蛇移动速度越来越快。3. 实现后做一次真正的检查实现代理完成页面和游戏逻辑后,检查代理重点验证了几个容易被忽略的分支:连续按方向键时,不能绕过“禁止直接反向”;食物只从未被蛇占用的格子里选择;蛇填满棋盘时要结束并显示胜利状态;碰撞结束和点击重开都要正确清理定时器;浏览器不支持 Canvas 时,页面不能直接报错。最后还补了 Canvas 不可用时的降级提示和禁用按钮样式。这类问题并不复杂,但如果没有一个独立检查环节,很容易因为“主流程能玩”就被忽略。4、效果图总结Trellis 适合的不是“让 AI 代替开发”,而是让 AI 的开发过程更可控。如果只是临时写一个脚本,完整流程可能显得有点重;但只要任务开始涉及多人协作、跨会话、项目规范或长期维护,Trellis 的价值会慢慢显现出来:需求有落点,规范能复用,检查有依据,下一次也不用从零解释。我觉得可以先从一个小项目试起:初始化 Trellis,补两三条真正会用到的 Spec,然后让 AI 完成一个完整的小功能。等你经历过一次“需求—实现—检查—归档”的闭环,再决定要不要把它放进日常开发流程。参考资料:Trellis GitHub 仓库Trellis npm 包安装与首个任务文档