
搜索到
57
篇与
的结果
-
 大模型“无脑复读”?3分钟搞懂原因+解决办法 最近在调用大模型时,遇到了一个十分棘手的怪象——模型输出陷入“死循环”,不停重复相同内容,像一台复读机,如下图所示。为了解决这个问题,我查阅了相关资料,梳理出大模型重复输出的现象分级、核心原因以及可解决办法,整理成文分享给大家,帮大家快速摆脱“复读机”困扰。一、现象分级:大模型“复读”分3种大模型的重复输出并非单一情况,根据重复的范围和程度,可分为以下3个级别,大家可以对照判断自己遇到的情况:词汇/短语级重复:最基础的重复形式,模型生成的文本中,同一个词语、短语或短句反复出现,比如一句话在同一段落中被多次复制粘贴,阅读起来十分冗余。段落级重复:当生成较长文本(如文章、方案)时,模型可能生成重复的句子群或完整段落,甚至出现与前文几乎完全一致的内容段,严重影响内容的完整性和可读性。内容结构级重复:针对结构化回答需求(如分点解析、步骤说明),模型可能多次使用相似的结构、句式进行解释,虽然核心内容略有差异,但整体框架重复,显得拖沓且缺乏新意。二、核心原因:3大因素导致模型“卡壳复读”1. 提示词问题(最常见,占比最高)需求提示不清晰:如果给模型的提示过于模糊、笼统,没有明确回答方向、范围或要求,模型无法精准捕捉需求,就会通过重复内容“凑数”,形成冗余输出。上下文缺失:模型的回答依赖上下文信息,如果提问时没有提供足够的背景、前提,或对话过程中上下文断裂,模型无法理解需求的核心,就容易陷入重复循环。2. 模型参数设置不合理温度(temperature)设置过低:温度值控制模型输出的随机性,当温度设置过低(如0),模型会生成保守、确定的内容,倾向于重复高概率词汇和句式,进而出现重复。Top-k/Top-p采样策略不当:这两个参数用于控制模型选择词汇的范围,若设置不合理,会导致模型只能选择少数高概率词汇,无法生成多样化内容,最终陷入重复。3. 模型本身的局限性最终的输出内容由大模型的核心算法、参数配置和训练数据决定。如果模型本身存在训练不充分、参数优化不足等问题,也可能导致其在生成内容时,容易出现重复输出的情况。三、解决办法:对症施策,快速解决“复读”问题针对上述原因,整理了可直接落地的解决办法,从易到难,大家可以按需尝试,基本能解决80%以上的重复输出问题:1. 优化提示词明确禁止重复:在提示词中直接添加“禁止输出重复信息”“避免重复句式和内容”等要求,直接约束模型的输出行为。丰富上下文:补充足够的背景信息、前提条件,或在对话中逐步递进提问,让模型清晰理解需求,避免因信息不足导致重复。细化需求+拆分问题:将模糊的需求拆解成更小的子问题,明确每个问题的回答方向(如“从3个不同角度解析XX”“分步骤说明XX”),引导模型生成多样化内容。2. 调整模型参数调整temperature:将温度值设置在0.7-0.9之间,这个区间既能保证输出内容的准确性,又能增加随机性,鼓励模型生成更多不同的内容,避免重复。优化Top-p采样:适当调整Top-p的值(通常设置在0.9左右),扩大模型选择词汇的范围,让模型有更多创作空间,减少重复概率。
-
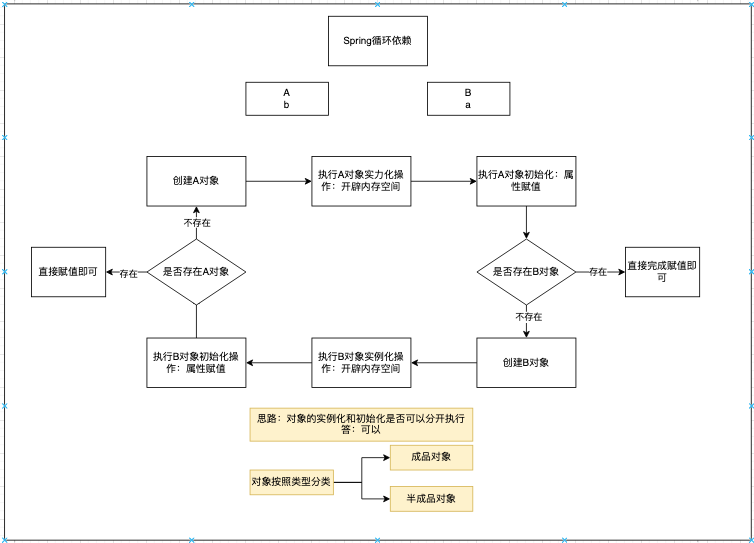
详细解析Spring如何解决循环依赖问题 在日常的Spring开发中,循环依赖是一个高频出现的问题,也是面试中的核心考点。本文将从概念定义、问题表现、核心原理到源码层面,全方位解析Spring是如何通过三级缓存机制优雅地解决单例Bean的循环依赖问题。一、什么是循环依赖?循环依赖,指的是两个或多个Bean之间互相持有对方的引用,形成闭环依赖关系。最典型的场景是Bean A依赖Bean B,同时Bean B又依赖Bean A。代码示例:@Component class A { // A依赖B @Resource private B b; } @Component class B { // B依赖A,形成循环 @Resource private A a; }在默认情况下,如果Spring不做特殊处理,项目启动时会抛出BeanCurrentlyInCreationException异常,提示存在循环依赖无法解决:二、Spring解决循环依赖的核心:三级缓存为了解决单例Bean的循环依赖问题,Spring设计了三级缓存机制,通过提前暴露半成品Bean的方式打破依赖闭环。三级缓存的定义缓存级别缓存名称作用一级缓存singletonObjects存放完全初始化完成的单例Bean(成品对象),供业务直接使用二级缓存earlySingletonObjects存放提前暴露的半成品Bean(已实例化但未完成属性填充和初始化)三级缓存singletonFactories存放ObjectFactory(对象工厂),这是一个函数式接口,仅在调用getObject()时才会创建Bean实例三、核心源码解析(基于 Spring 5.3.x)Spring处理Bean创建和循环依赖的核心逻辑集中在DefaultSingletonBeanRegistry类中,以下是关键源码及解析:public class DefaultSingletonBeanRegistry extends SimpleAliasRegistry implements SingletonBeanRegistry { // 一级缓存:存放完全初始化好的单例Bean (成品) private final Map<String, Object> singletonObjects = new ConcurrentHashMap<>(256); // 三级缓存:存放Bean的工厂对象,用于创建提前暴露的Bean (半成品工厂) private final Map<String, ObjectFactory<?>> singletonFactories = new HashMap<>(16); // 二级缓存:存放提前暴露的Bean实例 (半成品,未完成属性填充和初始化) private final Map<String, Object> earlySingletonObjects = new HashMap<>(16); // 记录当前正在创建的Bean名称,解决循环依赖的关键判断 private final Set<String> singletonsCurrentlyInCreation = Collections.newSetFromMap(new ConcurrentHashMap<>(16)); /** * 核心方法:获取单例Bean(解决循环依赖的入口) * @param beanName Bean名称 * @param allowEarlyReference 是否允许提前引用半成品Bean * @return 单例Bean实例 */ @Nullable public Object getSingleton(String beanName, boolean allowEarlyReference) { // 第一步:优先从一级缓存获取成品Bean Object singletonObject = this.singletonObjects.get(beanName); // 如果一级缓存没有,且当前Bean正在创建中(循环依赖的核心判断条件) if (singletonObject == null && isSingletonCurrentlyInCreation(beanName)) { // 第二步:从二级缓存获取提前暴露的半成品Bean singletonObject = this.earlySingletonObjects.get(beanName); // 如果二级缓存也没有,且允许提前引用 if (singletonObject == null && allowEarlyReference) { // 加锁保证并发安全 synchronized (this.singletonObjects) { // 双重检查(防止多线程下重复创建) singletonObject = this.singletonObjects.get(beanName); if (singletonObject == null) { singletonObject = this.earlySingletonObjects.get(beanName); if (singletonObject == null) { // 第三步:从三级缓存获取ObjectFactory ObjectFactory<?> singletonFactory = this.singletonFactories.get(beanName); if (singletonFactory != null) { // 通过工厂创建半成品Bean(提前暴露的核心操作) singletonObject = singletonFactory.getObject(); // 将半成品Bean放入二级缓存,同时移除三级缓存(避免重复创建) this.earlySingletonObjects.put(beanName, singletonObject); this.singletonFactories.remove(beanName); } } } } } } return singletonObject; } /** * 将Bean工厂放入三级缓存(提前暴露Bean的关键步骤) * 在Bean实例化后、属性填充前调用 */ protected void addSingletonFactory(String beanName, ObjectFactory<?> singletonFactory) { Assert.notNull(singletonFactory, "Singleton factory must not be null"); synchronized (this.singletonObjects) { if (!this.singletonObjects.containsKey(beanName)) { this.singletonFactories.put(beanName, singletonFactory); this.earlySingletonObjects.remove(beanName); this.registeredSingletons.add(beanName); } } } /** * 将完全初始化的Bean放入一级缓存,清理二、三级缓存 * 在Bean初始化完成后调用 */ protected void addSingleton(String beanName, Object singletonObject) { synchronized (this.singletonObjects) { this.singletonObjects.put(beanName, singletonObject); this.singletonFactories.remove(beanName); this.earlySingletonObjects.remove(beanName); this.registeredSingletons.add(beanName); this.singletonsCurrentlyInCreation.remove(beanName); } } }调试关键方法(建议收藏)在实际调试Spring源码时,建议重点关注以下核心方法的调用链路:getBean() - Bean获取的入口方法doGetBean() - 获取Bean的核心实现createBean() - 创建Bean的顶层方法doCreateBean() - 创建Bean的核心逻辑createBeanInstance() - Bean实例化(创建空对象)populateBean() - Bean属性填充(依赖注入的核心)四、循环依赖解决完整流程(以A和B为例)结合上文A依赖B、B依赖A的场景,我们拆解Spring解决循环依赖的完整执行流程(基于单例Bean + 字段注入):步骤 1:Spring启动,开始创建Bean A调用getBean(A),首先将A标记为「正在创建中」(singletonsCurrentlyInCreation.add("A"));通过反射创建A的空实例(ctro.newInstance()),此时A的属性b为null(实例化阶段);关键操作:调用addSingletonFactory()将A的ObjectFactory放入三级缓存;开始为A填充属性,发现依赖B,触发getBean(B)。步骤 2:创建Bean B(触发循环依赖)调用getBean(B),将B标记为「正在创建中」;通过反射创建B的空实例(ctro.newInstance()),此时B的属性a为null;调用addSingletonFactory()将B的ObjectFactory放入三级缓存;开始为B填充属性,发现依赖A,再次触发getBean(A)。步骤 3:解决循环依赖(从缓存获取A)执行getBean(A),检查一级缓存:A未完成初始化,无成品;检查标记:A处于「正在创建中」,符合循环依赖条件;检查二级缓存:无A的半成品实例;检查三级缓存:存在A的ObjectFactory,调用getObject()创建A的半成品实例;将A的半成品实例从三级缓存移至二级缓存;将半成品A返回给B,完成B的属性a填充。步骤 4:B完成初始化,反馈给AB完成属性填充,执行初始化方法(init-method/@PostConstruct);调用addSingleton(B),将B放入一级缓存,并清理其二、三级缓存;将成品B返回给A,完成A的属性b填充。步骤 5:A完成初始化,最终入池A完成属性填充,执行初始化方法;调用addSingleton(A),将A放入一级缓存,清理其二、三级缓存;移除A的「正在创建中」标记,循环依赖问题解决。补充说明:加入三级缓存后的Bean创建流程可参考下图:五、关键细节:为什么需要三级缓存?核心原因是为了支持AOP动态代理:延迟创建代理对象:ObjectFactory的getObject()方法中会调用getEarlyBeanReference(),该方法会判断当前Bean是否需要生成AOP代理。只有发生循环依赖时,才会提前创建代理对象;保证代理对象的唯一性:如果没有三级缓存,所有Bean都需要提前创建代理,破坏了Spring「初始化完成后再创建代理」的设计原则;避免重复代理:三级缓存的工厂模式确保代理对象只会被创建一次,放入二级缓存后就移除三级缓存,避免重复生成。如果仅使用二级缓存,所有Bean都必须在实例化阶段就创建代理,这会导致:代理对象创建时机提前,不符合Spring的初始化生命周期无循环依赖的Bean也会被提前代理,增加不必要的性能开销总结Spring通过三级缓存机制解决单例Bean的循环依赖问题,核心是提前暴露半成品Bean打破依赖闭环;三级缓存各司其职:一级缓存存成品、二级缓存存半成品、三级缓存存工厂(支持AOP延迟代理);解决循环依赖的核心流程是:实例化Bean → 放入三级缓存 → 填充属性触发循环 → 从缓存获取半成品 → 完成初始化放入一级缓存。
-
Java + EasyExcel 实现单个接口导出多个Excel 在日常开发中,我们经常会遇到 Excel 导出的需求,大多是单个接口导出单个 Excel 文件。但偶尔也会有特殊场景——需要一个接口同时导出两个(或多个)独立的 Excel 文件,比如同时导出“用户列表”和“订单列表”,方便用户一次性获取完整数据。今天就基于 Spring Boot + EasyExcel(目前主流稳定版本),分享一种简单、通用、可直接落地的实现方案,全程附完整代码,新手也能快速上手~一、核心问题与解决方案首先要明确一个关键前提:HTTP 协议单次响应只能返回一个字节流,无法直接返回两个独立的 Excel 文件(相当于一次请求只能下载一个文件)。那怎么实现“一个接口导出多个 Excel”?答案很简单——将多个 Excel 文件打包成 ZIP 压缩包,接口返回 ZIP 流,用户下载后解压,就能得到多个 Excel 文件。这是最通用、最合规的解决方案,既不违背 HTTP 协议,也能满足用户一次性获取多份文件的需求。二、前置准备:引入依赖首先在项目中引入 EasyExcel 核心依赖、ZIP 压缩依赖(用于打包多文件),以及 Spring Web 依赖(接口开发必备)。以下是 Maven 配置,Gradle 可对应转换,版本可根据自己项目需求微调(建议保持和示例一致,避免兼容问题)。<!-- EasyExcel 核心依赖 --> <dependency> <groupId>com.alibaba</groupId> <artifactId>easyexcel</artifactId> <version>4.0.3</version> </dependency> <!-- ZIP 压缩依赖(处理多文件打包) --> <dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-compress</artifactId> <version>1.27.1</version> </dependency> <!-- Spring Web 依赖(已有则忽略,接口开发必备) --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency>三、步骤1:定义Excel对应的实体类假设我们需要导出两个 Excel 文件:用户列表 和 订单列表,分别创建对应的实体类,通过 EasyExcel 的 @ExcelProperty 注解指定 Excel 表头名称(注解参数就是最终 Excel 中显示的表头)。实体类用 Lombok 的 @Data 注解简化 getter/setter 代码,无需手动编写,节省开发时间。3.1 用户实体类(UserData.java)import com.alibaba.excel.annotation.ExcelProperty; import lombok.Data; /** * 用户列表 Excel 对应的实体类 */ @Data public class UserData { // Excel 表头:用户ID @ExcelProperty("用户ID") private Long userId; // Excel 表头:用户名称 @ExcelProperty("用户名称") private String userName; // Excel 表头:手机号 @ExcelProperty("手机号") private String phone; }3.2 订单实体类(OrderData.java)import com.alibaba.excel.annotation.ExcelProperty; import lombok.Data; /** * 订单列表 Excel 对应的实体类 */ @Data public class OrderData { // Excel 表头:订单ID @ExcelProperty("订单ID") private String orderId; // Excel 表头:用户ID(关联用户表) @ExcelProperty("用户ID") private Long userId; // Excel 表头:订单金额 @ExcelProperty("订单金额") private Double amount; // Excel 表头:创建时间 @ExcelProperty("创建时间") private String createTime; }四、步骤2:封装通用工具类(核心)为了避免接口层代码冗余,我们封装一个工具类 ExcelZipExportUtil,专门处理“将多个 Excel 写入 ZIP 流”和“初始化 HTTP 响应头”的逻辑。这个工具类是通用的,后续不管导出多少个 Excel,都能直接复用,无需重复编码。import com.alibaba.excel.EasyExcel; import org.apache.commons.compress.archivers.zip.ZipArchiveEntry; import org.apache.commons.compress.archivers.zip.ZipArchiveOutputStream; import javax.servlet.ServletOutputStream; import javax.servlet.http.HttpServletResponse; import java.io.ByteArrayOutputStream; import java.net.URLEncoder; import java.util.List; /** * EasyExcel 多文件导出 ZIP 工具类(通用可复用) */ public class ExcelZipExportUtil { /** * 将单个 Excel 文件写入 ZIP 输出流 * @param zipOut ZIP 输出流 * @param excelFileName 单个 Excel 的文件名(如:用户列表.xlsx) * @param data Excel 中的数据列表 * @param clazz Excel 对应的实体类(用于解析表头) */ public static <T> void writeExcelToZip(ZipArchiveOutputStream zipOut, String excelFileName, List<T> data, Class<T> clazz) throws Exception { // 1. 临时存储 Excel 内容(内存级,不写入磁盘,性能更高) ByteArrayOutputStream bos = new ByteArrayOutputStream(); // 2. 使用 EasyExcel 写入数据(sheet1 是工作表名称,可自定义) EasyExcel.write(bos, clazz) // 不要自动关闭,交给 Servlet 自己处理 .autoCloseStream(false) // 基于 column 长度,自动适配。最大 255 宽度 .registerWriteHandler(new LongestMatchColumnWidthStyleStrategy()) // 避免 Long 类型丢失精度 .registerConverter(new LongStringConverter()) // 工作表名称 .sheet("sheet1") .doWrite(data); // 3. 将 Excel 作为 ZIP 的一个条目写入 zipOut.putArchiveEntry(new ZipArchiveEntry(excelFileName)); zipOut.write(bos.toByteArray()); zipOut.closeArchiveEntry(); // 关闭当前 ZIP 条目(必须,否则后续条目无法写入) // 4. 关闭临时流 bos.close(); } /** * 初始化 HTTP 响应头(设置 ZIP 下载、解决中文文件名乱码) * @param response 响应对象 * @param zipFileName 最终下载的 ZIP 压缩包名称(如:用户订单数据.zip) */ public static void initZipResponse(HttpServletResponse response, String zipFileName) throws Exception { // 设置响应类型为 ZIP response.setContentType("application/zip"); // 设置下载头,URLEncoder.encode 解决中文文件名乱码(兼容所有浏览器) response.setHeader("Content-Disposition", "attachment;filename=" + URLEncoder.encode(zipFileName, "UTF-8")); // 禁止缓存(避免浏览器缓存旧文件) response.setHeader("Pragma", "no-cache"); response.setHeader("Cache-Control", "no-cache"); } }五、步骤3:接口层实现(最终落地)创建 Controller 接口,模拟构造两个 Excel 的测试数据(实际项目中,这里可以替换成从数据库查询数据),然后调用上面封装的工具类,将两个 Excel 打包成 ZIP 流,通过 HttpServletResponse 返回,实现“一次请求下载两个 Excel”。import org.apache.commons.compress.archivers.zip.ZipArchiveOutputStream; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import javax.servlet.http.HttpServletResponse; import java.util.ArrayList; import java.util.List; /** * Excel 导出接口控制器 */ @RestController @RequestMapping("/export") public class ExcelExportController { /** * 单个接口导出两个 Excel 文件(打包成 ZIP 下载) * 访问地址:http://localhost:8080/export/twoExcel */ @GetMapping("/twoExcel") public void exportTwoExcel(HttpServletResponse response) { try { // 1. 初始化响应头,设置 ZIP 压缩包名称(用户下载时显示的文件名) ExcelZipExportUtil.initZipResponse(response, "用户订单数据.zip"); // 2. 获取 HTTP 响应输出流,关联 ZIP 输出流 ServletOutputStream servletOut = response.getOutputStream(); ZipArchiveOutputStream zipOut = new ZipArchiveOutputStream(servletOut); // 3. 构造第一个 Excel 的数据(用户列表,实际项目中替换为数据库查询) List<UserData> userList = new ArrayList<>(); // 3.1 完善数据逻辑省略 // 4. 构造第二个 Excel 的数据(订单列表,实际项目中替换为数据库查询) List<OrderData> orderList = new ArrayList<>(); // 4.1 完善数据逻辑省略 // 5. 关键操作:将两个 Excel 分别写入 ZIP 流 ExcelZipExportUtil.writeExcelToZip(zipOut, "用户列表.xlsx", userList, UserData.class); ExcelZipExportUtil.writeExcelToZip(zipOut, "订单列表.xlsx", orderList, OrderData.class); // 6. 关闭流(顺序不能错!否则 ZIP 包会损坏,无法解压) zipOut.finish(); // 完成 ZIP 写入 zipOut.close(); servletOut.flush(); servletOut.close(); } catch (Exception e) { e.printStackTrace(); // 实际项目中建议自定义异常处理,给前端返回明确的错误提示 response.setStatus(500); } } }六、关键注意事项(避坑重点)这部分一定要仔细看!很多新手实现后,出现 ZIP 包损坏、中文乱码、数据缺失等问题,大多是因为忽略了这些细节。流的关闭顺序:必须先执行 zipOut.closeArchiveEntry()(关闭当前 ZIP 条目),再执行 zipOut.finish(),最后关闭 ZIP 流和响应流。顺序颠倒会导致 ZIP 包损坏,无法解压。中文文件名乱码:通过 URLEncoder.encode(zipFileName, "UTF-8") 对 ZIP 文件名和 Excel 文件名编码,兼容 Chrome、Firefox、Edge 等所有主流浏览器,避免中文乱码。Excel 写入方式:示例中使用 ByteArrayOutputStream 临时存储 Excel 内容,属于内存级写入,不占用磁盘空间,性能更高。不建议直接写入磁盘文件再打包,会增加磁盘 IO 开销。异常处理:实际项目中,建议替换 try-catch 中的 printStackTrace(),使用全局异常处理器,给前端返回明确的错误信息(如“导出失败,请重试”),提升用户体验。七、扩展:导出更多Excel文件如果需要导出 3 个、4 个甚至更多 Excel 文件,无需修改工具类,只需在接口中继续调用 ExcelZipExportUtil.writeExcelToZip() 方法即可。示例(新增“商品列表”Excel):// 新增商品列表数据(假设已有 GoodsData 实体类) List<GoodsData> goodsList = new ArrayList<>(); // ... 构造商品数据 // 新增一个 Excel 写入 ZIP 流 ExcelZipExportUtil.writeExcelToZip(zipOut, "商品列表.xlsx", goodsList, GoodsData.class);八、测试效果验证代码写完后,启动 Spring Boot 项目,通过以下步骤测试,确保导出正常:访问接口地址:http://localhost:8080/export/twoExcel(端口号根据自己项目配置调整);浏览器会自动弹出下载提示,下载的文件名为“用户订单数据.zip”;解压 ZIP 压缩包,会得到两个 Excel 文件:用户列表.xlsx 和 订单列表.xlsx;打开 Excel 文件,检查表头和数据是否正常(和接口中构造的测试数据一致)。九、总结代码通用可复用,总结下来就是 3 步:引入 EasyExcel 和 ZIP 依赖,做好前置准备;定义 Excel 对应的实体类,封装通用工具类(处理 ZIP 打包和响应头);在接口中构造数据,调用工具类将多个 Excel 写入 ZIP 流,返回给前端。该方案适用于所有 Spring Boot 项目,支持任意数量的 Excel 导出,避开了新手常踩的坑(流顺序、中文乱码),直接复制代码就能落地使用。如果你的项目中有类似需求,不妨试试这个方案~
-
Jakarta Validation 优雅实现参数校验:从基础使用到自定义扩展 在后端开发中,参数校验是保障接口安全性和数据合法性的核心环节,硬编码的if-else校验逻辑不仅繁琐冗余,还会让代码可读性大打折扣。Jakarta Validation(原Java Validation)为我们提供了一套轻量、优雅的注解式参数校验方案,通过标准化的注解即可实现各类参数校验规则,大幅简化开发流程。本文将从基础注解使用、实战场景落地、统一异常处理到自定义校验注解,全方位讲解Jakarta Validation的使用技巧,结合实际业务代码示例,让你快速上手并灵活运用到项目中。一、核心校验注解速查Jakarta Validation提供了一系列开箱即用的校验注解,覆盖空值、长度、格式、数值、日期等绝大多数日常校验场景,核心注解及功能如下表所示,可直接作为开发速查手册:注解适用类型核心功能@NotNull所有类型字段值不能为null@NotBlank字符串不能为null,且去除首尾空格后长度大于0@NotEmpty字符串/集合/数组不能为null,且长度/元素个数大于0@Size(min, max)字符串/集合/数组长度/元素个数在[min, max]范围内@Pattern(regexp)字符串必须匹配指定的正则表达式@Email字符串必须符合合法的邮箱格式(支持自定义正则)@Min(value)数值类型数值必须大于等于value@Max(value)数值类型数值必须小于等于value@Positive数值类型必须为正数(大于0)@Negative数值类型必须为负数(小于0)@PositiveOrZero数值类型必须为正数或0@NegativeOrZero数值类型必须为负数或0@Future日期/时间类型必须是未来的时间@FutureOrPresent日期/时间类型必须是未来或当前时间@Past日期/时间类型必须是过去的时间@PastOrPresent日期/时间类型必须是过去或当前时间注解使用小技巧@NotBlank/@NotEmpty/@NotNull 区分:字符串优先用@NotBlank(过滤空白字符),集合/数组用@NotEmpty,非字符串非集合类型用@NotNull;注解组合使用:实际业务中可组合多个注解,如用户账号需同时满足「非空、正则匹配、长度限制」;默认提示语自定义:所有注解都支持message属性,用于自定义校验失败的提示信息,贴合业务场景。二、实战场景落地:三种核心使用方式Jakarta Validation的注解可根据参数传递方式灵活使用,核心分为「简单参数直接注解」「实体对象属性注解」两种核心场景,后者是项目中最常用的方式。场景1:GET请求简单参数,直接注解参数对于GET请求的URL拼接参数(如/user/get?name=test&id=1),可直接在接口方法的参数前添加校验注解,适用于参数数量少的简单场景。/** * 根据用户名和ID查询用户 * @param name 用户名(不能为空) * @param id 用户ID(必须为正数) * @return 用户信息 */ @GetMapping("/get") public CommonResult<UserVO> getUser( @NotBlank(message = "用户名不能为空") String name, @Positive(message = "用户ID必须为正数") Long id ) { UserVO user = userService.getByNameAndId(name, id); return CommonResult.success(user); }场景2:POST请求实体参数,注解+@Valid 触发校验对于POST/PUT请求,参数通常封装为实体对象(如新增/编辑用户的入参),只需在实体的属性上添加校验注解,并在接口方法的实体参数前添加@Valid(或@Validated)注解,即可触发整体校验逻辑。这是项目中最常用的方式,适合复杂参数的校验场景。步骤1:实体类添加校验注解@Data @Schema(description = "新增用户请求参数") public class UserSaveReqVO { @Schema(description = "用户编号(编辑时传,新增时不传)", example = "1024") private Long id; @Schema(description = "用户账号", requiredMode = Schema.RequiredMode.REQUIRED, example = "yudao") @NotBlank(message = "用户账号不能为空") @Pattern(regexp = "^[a-zA-Z0-9]+$", message = "用户账号仅支持数字、字母组成") @Size(min = 4, max = 30, message = "用户账号长度为4-30个字符") private String username; @Schema(description = "用户密码", requiredMode = Schema.RequiredMode.REQUIRED, example = "123456a") @NotBlank(message = "用户密码不能为空") @Size(min = 6, max = 20, message = "用户密码长度为6-20个字符") private String password; @Schema(description = "用户年龄", example = "25") @Min(value = 18, message = "用户年龄不能小于18岁") @Max(value = 60, message = "用户年龄不能大于60岁") private Integer age; @Schema(description = "邮箱", example = "test@example.com") @NotBlank(message = "邮箱不能为空") @Email(message = "邮箱格式不合法") private String email; }步骤2:接口方法添加@Valid 触发校验@PostMapping("/create") @Operation(summary = "新增用户") public CommonResult<Long> createUser(@Valid @RequestBody UserSaveReqVO reqVO) { Long userId = userService.createUser(reqVO); return CommonResult.success(userId); }关键区别:@Valid vs @Validated@Valid:属于JSR-380标准注解,支持嵌套实体校验(如实体中包含另一个实体属性);@Validated:属于Spring扩展注解,支持分组校验(如新增和编辑用户时,同一实体的校验规则不同),可替代@Valid使用。嵌套实体校验示例:如果UserSaveReqVO中包含AddressVO实体属性,只需在AddressVO属性上添加@Valid+自身属性注解,即可触发嵌套校验。@Data public class UserSaveReqVO { // 其他属性... @Schema(description = "用户地址") @Valid // 触发嵌套校验 @NotNull(message = "用户地址不能为空") private AddressVO address; } @Data public class AddressVO { @NotBlank(message = "省不能为空") private String province; @NotBlank(message = "市不能为空") private String city; }三、全局异常拦截:统一处理校验失败结果当参数校验失败时,Jakarta Validation会自动抛出异常,不同场景抛出的异常类型不同:简单参数校验失败:抛出ConstraintViolationException;实体对象校验失败:抛出MethodArgumentNotValidException。为了让前端能接收到统一格式的错误返回,我们需要在项目中添加全局异常处理器,拦截这些校验异常,封装成统一的返回结果。全局异常处理器实现结合Spring Boot的@RestControllerAdvice和@ExceptionHandler实现全局异常拦截,统一返回格式(如包含错误码、错误信息的CommonResult)。@RestControllerAdvice @Slf4j public class GlobalExceptionHandler { /** * 处理实体对象参数校验失败异常(@Valid + 实体注解) */ @ExceptionHandler(MethodArgumentNotValidException.class) public CommonResult<?> handleMethodArgumentNotValid(MethodArgumentNotValidException ex) { log.warn("参数校验失败:{}", ex.getMessage()); // 获取校验失败的第一条错误信息 String errorMsg = getFirstValidErrorMessage(ex.getBindingResult()); return CommonResult.error(HttpStatus.BAD_REQUEST.value(), "请求参数不正确:" + errorMsg); } /** * 处理简单参数校验失败异常(直接注解参数) */ @ExceptionHandler(ConstraintViolationException.class) public CommonResult<?> handleConstraintViolation(ConstraintViolationException ex) { log.warn("参数校验失败:{}", ex.getMessage()); // 获取校验失败的第一条错误信息 String errorMsg = ex.getConstraintViolations().stream() .map(ConstraintViolation::getMessage) .findFirst() .orElse("参数校验失败"); return CommonResult.error(HttpStatus.BAD_REQUEST.value(), "请求参数不正确:" + errorMsg); } /** * 提取BindingResult中的第一条错误信息 */ private String getFirstValidErrorMessage(BindingResult bindingResult) { // 优先获取字段级别的错误 if (bindingResult.hasFieldErrors()) { return bindingResult.getFieldErrors().get(0).getDefaultMessage(); } // 无字段错误则获取全局错误 if (bindingResult.hasGlobalErrors()) { return bindingResult.getGlobalErrors().get(0).getDefaultMessage(); } return "参数校验失败"; } }异常处理小技巧返回第一条错误信息:避免返回所有错误信息导致前端展示混乱,优先返回第一条校验失败的信息;统一错误码:参数校验失败统一使用400(BAD_REQUEST)错误码,符合HTTP协议规范;日志记录:记录异常日志便于问题排查,但无需打印完整堆栈(非运行时异常,属于业务异常)。四、高级扩展:自定义校验注解Jakarta Validation提供的默认注解无法覆盖所有业务场景(如「参数必须为指定枚举值」「手机号格式校验」「身份证号校验」),此时可通过自定义校验注解实现个性化的校验规则,步骤固定且可复用。实战示例:实现「参数必须为指定枚举值」的自定义注解以最常见的「参数必须是枚举中的某个值」为例,实现自定义注解@InEnum,支持校验参数是否为指定枚举的有效值。步骤1:定义自定义注解通过@Constraint指定校验器实现类,注解的属性可传递自定义参数(如枚举类),同时指定注解的适用目标(字段、参数等)。@Target({ ElementType.METHOD, ElementType.FIELD, ElementType.PARAMETER, ElementType.ANNOTATION_TYPE }) @Retention(RetentionPolicy.RUNTIME) @Documented // 指定校验器实现类:InEnumValidator @Constraint(validatedBy = {InEnumValidator.class}) public @interface InEnum { /** * 校验失败的提示语 */ String message() default "必须为指定枚举值:{value}"; /** * 分组校验(可省略,默认空) */ Class<?>[] groups() default {}; /** * 负载(可省略,默认空) */ Class<? extends Payload>[] payload() default {}; /** * 目标枚举类(必须实现ArrayValuable接口,提供枚举值数组) */ Class<? extends ArrayValuable<?>> value(); } /** * 枚举值获取接口,所有需要被@InEnum校验的枚举需实现此接口 * @param <T> 枚举值类型 */ public interface ArrayValuable<T> { /** * 获取枚举的所有值数组 */ T[] array(); }步骤2:实现注解校验器实现ConstraintValidator<A, T>接口,其中A为自定义注解,T为被校验的参数类型,重写initialize(初始化注解参数)和isValid(核心校验逻辑)方法。@Slf4j public class InEnumValidator implements ConstraintValidator<InEnum, Object> { /** * 枚举的有效值集合 */ private List<?> validValues; /** * 初始化:获取注解中指定的枚举类,提取其有效值 */ @Override public void initialize(InEnum annotation) { Class<? extends ArrayValuable<?>> enumClass = annotation.value(); // 获取枚举的所有实例 ArrayValuable<?>[] enumConstants = enumClass.getEnumConstants(); if (ArrayUtil.isEmpty(enumConstants)) { this.validValues = Collections.emptyList(); return; } // 提取枚举的有效值数组,转为List方便判断 this.validValues = Arrays.asList(enumConstants[0].array()); } /** * 核心校验逻辑 * @param value 被校验的参数值 * @param context 校验上下文 * @return true=校验通过,false=校验失败 */ @Override public boolean isValid(Object value, ConstraintValidatorContext context) { // 1. 参数为null时,默认校验通过(如需非空,可配合@NotNull注解) if (value == null) { return true; } // 2. 参数值在枚举有效值集合中,校验通过 if (validValues.contains(value)) { return true; } // 3. 校验失败,自定义提示语(替换{value}为实际枚举有效值) context.disableDefaultConstraintViolation(); context.buildConstraintViolationWithTemplate( context.getDefaultConstraintMessageTemplate() .replace("{value}", validValues.toString()) ).addConstraintViolation(); return false; } }步骤3:枚举实现接口并使用自定义注解让目标枚举实现ArrayValuable接口,提供有效值数组,然后在实体/参数上添加@InEnum注解即可。/** * 性别枚举 */ public enum GenderEnum implements ArrayValuable<Integer> { MALE(1, "男"), FEMALE(2, "女"); private final Integer code; private final String name; GenderEnum(Integer code, String name) { this.code = code; this.name = name; } @Override public Integer[] array() { // 返回枚举的有效值数组 return new Integer[]{MALE.getCode(), FEMALE.getCode()}; } public Integer getCode() { return code; } } // 在实体中使用@InEnum注解 @Data public class UserSaveReqVO { // 其他属性... @Schema(description = "性别(1=男,2=女)", example = "1") @NotNull(message = "性别不能为空") @InEnum(value = GenderEnum.class, message = "性别必须为{value}") private Integer gender; }自定义注解开发通用规范注解属性规范:必须包含message/groups/payload三个基础属性(符合Jakarta Validation标准);空值处理:校验器中默认对null放行,如需非空可配合@NotNull注解,解耦「非空校验」和「业务规则校验」;提示语自定义:通过context.disableDefaultConstraintViolation()禁用默认提示语,实现动态替换(如替换枚举有效值);可复用性:自定义注解应设计为通用型(如手机号、身份证号校验注解),可在项目中全局复用。五、实用进阶技巧1. 分组校验:同一实体不同场景不同校验规则实际开发中,新增和编辑用户时,同一实体的校验规则可能不同(如新增时id无需传,编辑时id必须传),可通过分组校验实现,基于@Validated的分组属性。步骤1:定义分组标识接口/** * 校验分组 - 新增 */ public interface AddGroup { } /** * 校验分组 - 编辑 */ public interface EditGroup { }步骤2:实体注解指定分组@Data public class UserSaveReqVO { @Schema(description = "用户编号", example = "1024") @NotNull(message = "用户ID不能为空", groups = EditGroup.class) // 仅编辑时校验id非空 private Long id; @NotBlank(message = "用户账号不能为空", groups = {AddGroup.class, EditGroup.class}) // 新增+编辑都校验 private String username; }步骤3:接口指定分组触发校验// 新增用户:使用AddGroup分组 @PostMapping("/create") public CommonResult<Long> createUser(@Validated(AddGroup.class) @RequestBody UserSaveReqVO reqVO) { return CommonResult.success(userService.createUser(reqVO)); } // 编辑用户:使用EditGroup分组 @PutMapping("/edit") public CommonResult<Boolean> editUser(@Validated(EditGroup.class) @RequestBody UserSaveReqVO reqVO) { return CommonResult.success(userService.editUser(reqVO)); }六、总结Jakarta Validation通过注解式编程让参数校验从繁琐的硬编码中解放出来,实现了「校验规则和业务逻辑的解耦」,让代码更简洁、优雅、易维护。合理使用Jakarta Validation,不仅能提升开发效率,还能让接口的参数校验更规范、更健壮,为项目的稳定性提供保障。
-
Spring Retry 重试机制:优雅解决接口调用失败问题 在日常开发中,我们经常会遇到第三方接口不稳定、网络抖动导致的调用失败场景。很多人第一反应是在 try-catch 里写 for 循环重试,再搭配 Thread.sleep() 控制间隔——这种写法不仅冗余,还难以维护。今天给大家推荐 Spring Retry 框架,它基于 AOP 实现,能让你零侵入式地为方法添加重试功能,大幅简化代码!一、快速上手:三步集成 Spring Retry1. 添加 Maven 依赖Spring Retry 核心依赖 + AOP 依赖(因为其底层是 AOP 实现),这里推荐使用 2.0.12 稳定版本:<!-- Spring Retry 核心依赖 --> <dependency> <groupId>org.springframework.retry</groupId> <artifactId>spring-retry</artifactId> <version>2.0.12</version> </dependency> <!-- AOP 依赖(Spring Boot 项目推荐此 starter) --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-aop</artifactId> </dependency>2. 启用 Spring Retry 功能在 Spring Boot 主启动类上添加 @EnableRetry 注解,一键开启重试功能:import org.springframework.retry.annotation.EnableRetry; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; @EnableRetry // 启用重试功能 @SpringBootApplication public class SpringRetryDemoApplication { public static void main(String[] args) { SpringApplication.run(SpringRetryDemoApplication.class, args); } }3. 核心注解:@Retryable 标记重试方法在需要重试的方法上添加 @Retryable 注解,即可实现重试逻辑。基础用法import org.springframework.retry.annotation.Retryable; import org.springframework.stereotype.Service; @Service public class RetryDemoService { // 标记该方法需要重试 @Retryable public void basicRetry() { int random = (int) (Math.random() * 10); System.out.println("当前随机数:" + random); // 模拟异常:随机数为偶数时抛出异常 if (random % 2 == 0) { throw new RuntimeException("随机数为偶数,触发异常"); } System.out.println("方法执行成功!"); } }基础用法说明未指定异常类型时,方法抛出任何异常都会触发重试。默认重试次数:3次(包含首次执行,实际重试 2 次)。默认重试间隔:1秒。当重试次数耗尽仍失败时,会抛出 ExhaustedRetryException 异常。二、进阶配置:灵活定制重试策略@Retryable 注解提供了丰富的属性,可根据业务需求精准控制重试逻辑。1. @Retryable 核心属性说明属性名作用示例value/retryFor指定触发重试的异常类型retryFor = RuntimeException.classinclude同 value,优先级更高include = {NullPointerException.class}exclude指定不触发重试的异常类型exclude = IllegalArgumentException.classmaxAttempts最大重试次数(包含首次执行)maxAttempts = 5backoff配置重试间隔策略@Backoff(delay = 1000, multiplier = 2)stateful是否有状态重试(异常信息保留)stateful = true2. 实战示例:指数退避重试需求:调用第三方接口时,仅在抛出 RuntimeException 时重试,最大重试 5 次,重试间隔按 1s → 2s → 4s → 8s 指数增长(避免高频重试压垮接口)。import org.springframework.retry.annotation.Backoff; import org.springframework.retry.annotation.Retryable; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RestController; @RestController public class RetryDemoController { @GetMapping("/test/retry") // 仅对RuntimeException重试,最大5次,指数退避间隔 @Retryable( retryFor = RuntimeException.class, maxAttempts = 5, backoff = @Backoff(delay = 1000, multiplier = 2.0) ) public String testRetry() { int random = (int) (Math.random() * 10); System.out.println("[" + System.currentTimeMillis() + "] 当前随机数:" + random); if (random % 2 == 0) { throw new RuntimeException("随机数为偶数,触发重试"); } return "调用成功!随机数:" + random; } }三、兜底处理:@Recover 重试失败后的恢复逻辑当重试次数耗尽仍失败时,我们需要一个兜底方法来处理最终的失败(比如记录日志、返回默认结果),这时候就需要 @Recover 注解。1. @Recover 用法规则恢复方法和 @Retryable 方法应该在同一个类中。后续参数需和 @Retryable 方法的参数列表完全一致。返回值需和 @Retryable 方法的返回值完全一致。2. 实战示例:重试失败后返回默认结果import org.springframework.retry.annotation.Recover; import org.springframework.retry.annotation.Retryable; import org.springframework.stereotype.Service; @Service public class RetryDemoService { @Retryable( retryFor = RuntimeException.class, maxAttempts = 3, backoff = @Backoff(delay = 1000) ) public String callThirdPartyApi(String param) { System.out.println("调用第三方接口,参数:" + param); // 模拟接口调用失败 throw new RuntimeException("第三方接口超时"); } // 重试失败后的恢复方法 @Recover public String recover(RuntimeException e, String param) { System.out.println("重试次数耗尽,执行兜底逻辑!异常信息:" + e.getMessage()); System.out.println("请求参数:" + param); // 返回默认结果 return "接口调用失败,已触发兜底策略"; } }四、注意事项(避坑指南)@Retryable 不能修饰 private 方法:因为 Spring AOP 无法代理 private 方法,重试逻辑会失效。避免同类方法调用:如果在同一个类中调用 @Retryable 方法(非代理调用),重试逻辑也会失效。重试策略要合理:避免设置过短的间隔和过多的重试次数,增加服务压力。五、总结Spring Retry 凭借注解化的方式,让我们摆脱了手写重试逻辑的繁琐,实现了代码的优雅和解耦。核心要点如下:三步集成:加依赖 → 启注解 → 标记方法。灵活配置:通过 @Retryable 属性定制重试次数、间隔、触发异常。兜底保障:通过 @Recover 处理重试失败的最终逻辑。掌握 Spring Retry,能让你在应对不稳定接口时更加从容,大幅提升系统的健壮性!